 你可能已经见过无数次这个词Transformer。这篇不从公式堆起而是先回答一个最重要的问题Transformer 到底是怎样把一串 Token变成对上下文的理解再一步步生成结果的Transformer 为什么会出现在 Transformer 之前处理文本序列常见的方案是 RNN、LSTM。它们有一个很直观的特点按顺序处理。例如一句话我 → 喜欢 → 学习 → 人工智能RNN 往往需要先处理“我”再处理“喜欢”然后才能继续处理后面的词。这种方式能够保留序列信息但也带来两个明显问题。一个是并行能力有限。前一步没有处理完后一步通常不能完全独立计算在 GPU 上很难把整段序列充分并行起来。另一个是长距离依赖难处理。一句话很长时前面的信息要经过很多步才能影响后面的词虽然 LSTM 等结构已经缓解了这个问题但依然存在较长的信息传递路径。2017 年Vaswani 等人在论文《Attention Is All You Need》中提出 Transformer不再依赖循环结构而是让序列中的 Token 通过 Attention 直接建立联系。这带来一个关键变化RNNToken1 → Token2 → Token3 → Token4TransformerToken1 ↔ Token2 ↔ Token3 ↔ Token4 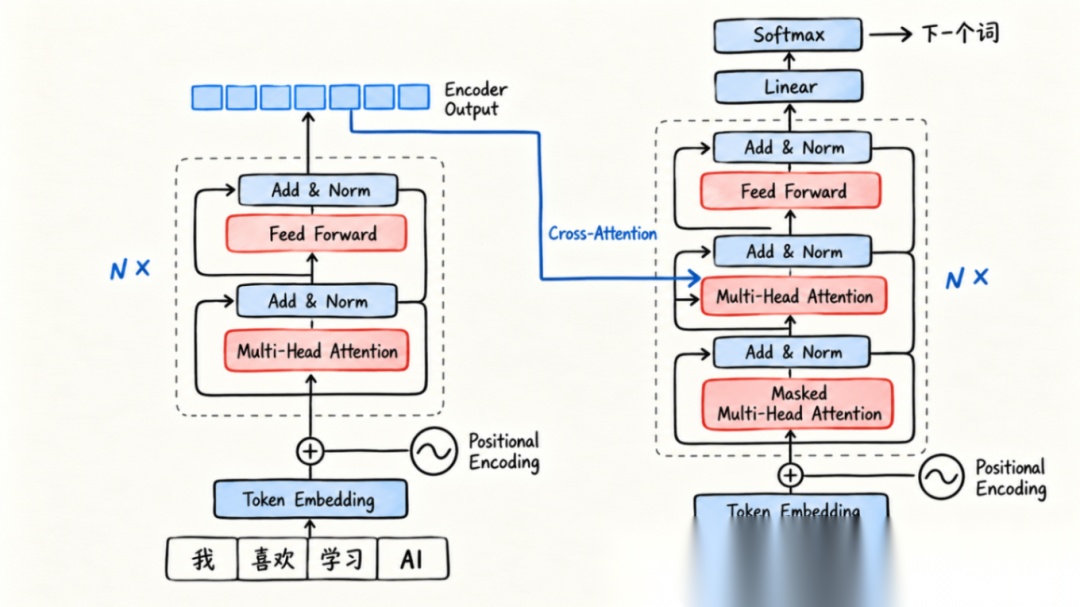 Transformer 的核心思路不是“一个词接一个词地记”而是 让每个 Token 都有机会直接观察序列中的其他 Token再决定哪些信息与自己最相关。 这就是 Self-Attention 的价值。 Transformer 到底是什么 ------------------ 从完整结构看原始 Transformer 是一个典型的 Encoder–Decoder编码器–解码器架构。 可以先把它理解成两部分 plaintext 输入文本 ↓Encoder理解输入内容 ↓上下文表示 ↓Decoder根据上下文生成输出 ↓输出文本比如机器翻译I love machine learning ↓ Encoder ↓ 输入语义表示 ↓ Decoder ↓我喜欢机器学习Encoder 负责把输入“读懂”。Decoder 负责根据 Encoder 提供的信息以及自己已经生成的内容继续预测下一个 Token。在进入 Encoder 之前Token 先变成向量神经网络不能直接理解汉字或英文单词。文本通常先经过 Tokenizer被拆成 Token然后通过 Embedding 映射成向量。例如“我喜欢AI” ↓Tokenization ↓[我] [喜欢] [AI] ↓Embedding ↓向量1 向量2 向量3Embedding可以理解为把离散的 Token 转换成神经网络能够计算的一串数字。但这里只有“这个 Token 是什么”还缺一个重要信息它在句子里的什么位置因为 Self-Attention 本身不会像 RNN 一样天然按照先后顺序逐个处理 Token所以 Transformer 还需要加入位置信息。原始论文使用的是 Positional Encoding位置编码。于是进入 Transformer 层之前输入大致可以理解为Token Embedding Position Encoding ↓带有“内容 位置”信息的向量现代模型还会使用 RoPE 等其他位置编码方式但目的类似让模型知道 Token 之间的顺序和相对位置。Encoder 是怎么工作的一个经典 Transformer Encoder Layer可以先简化成两大模块输入 ↓Multi-Head Self-Attention ↓Add Norm ↓Feed Forward Network ↓Add Norm ↓输出这里最重要的是两件事Self-Attention 负责让不同 Token 交换上下文信息。Feed Forward Network 负责进一步处理每个 Token 得到的新表示。除此之外还有 Residual Connection残差连接和 Layer Normalization层归一化它们主要帮助深层网络稳定训练和传递信息。真正理解 Encoder关键还是 Self-Attention。Self-Attention 到底在算什么假设有一句话小明把苹果放在桌子上因为它很稳。看到“它”时人会结合上下文判断“它”更可能指向“桌子”。模型也需要完成类似的事情当前这个 Token应该重点关注上下文中的哪些 TokenSelf-Attention 就是在做这个计算。为了完成注意力计算每个 Token 会生成三组向量QQueryKKeyVValue可以先用非常粗略的方式理解• Q我现在想找什么信息• K我这里有什么特征可以被匹配• V如果你关注我我真正提供什么内容例如当前 Token 的 Q会和其他 Token 的 K 计算相似度。匹配程度越高说明当前 Token 越应该关注那个位置。整个过程可以简化为Q 和所有 K 做匹配 ↓得到注意力分数 ↓Softmax 转成权重 ↓按权重组合 V ↓得到新的上下文表示经典的 Scaled Dot-Product Attention 写成公式是Attention(Q, K, V) softmax(QKᵀ / √dₖ) V不用急着记公式。真正要记住的是Q 和 K 决定“关注谁”V 决定“拿什么信息回来”。这就是 Attention 最核心的逻辑。为什么还要 Multi-Head Attention如果只做一次 Attention模型可能只从一种关系理解句子。但语言里的关系很多。同一个 Token 可能同时需要关注• 谁是主语• 谁是宾语• 哪个词在修饰自己• 前后有哪些语义关联• 远距离位置上有没有关键信息所以 Transformer 不是只做一组 Attention而是同时使用多组不同的 Q、K、V 投影。这就是 Multi-Head Attention多头注意力。可以把它理解成同一段文本 ↓Head 1关注语法关系Head 2关注指代关系Head 3关注局部搭配Head 4关注长距离信息 ↓拼接 ↓得到更丰富的表示这里的“关注什么”并不是人工提前规定的而是在训练过程中学习出来的。因此多头注意力真正解决的是让模型能够从多个表示子空间同时观察 Token 之间的关系。Attention 后面为什么还有 FFNSelf-Attention 解决的是 Token 之间的信息交互。但信息交换完之后每个 Token 自己还需要继续“加工”。所以 Encoder 中还有 Feed Forward Network简称 FFN。经典形式可以简化成Token 表示 ↓Linear ↓激活函数 ↓Linear ↓新的 Token 表示它和 Attention 的职责不同Attention不同 Token 之间交换信息FFN对每个 Token 的表示继续做非线性变换这两类模块交替组合构成一个完整的 Transformer Layer。多个 Layer 再层层堆叠模型就能够逐步形成更复杂的表示。Add Norm 又是什么Transformer 架构图中经常还能看到Add Norm它主要包含两个东西。Residual Connection也叫残差连接。它不是只把某个子模块的输出继续往下传而是把输入也加回来输出 输入 子模块(输入)这样可以让原始信息更容易跨层传递也有助于深层网络训练。Layer NormalizationLayerNorm 会对特征做归一化处理帮助训练过程更加稳定。所以看到Attention ↓Add Norm不要把它理解成另一个复杂的“智能模块”。它更像是为了让整个深层网络稳定运行的重要结构设计。需要注意的是原始 Transformer 论文与很多现代大模型在 LayerNorm 的具体放置顺序上并不完全相同。理解整体架构时先知道它承担“稳定训练和信息传递”的作用就够了。一个完整的 Transformer 流程把前面的模块全部串起来原始 Transformer 可以简化成下面这条链路输入文本 ↓Tokenizer ↓Embedding Position ↓Encoder Self-Attention ↓Encoder FFN ↓上下文表示 ↓────────────────────── ↓Decoder 输入 ↓Embedding Position ↓Masked Self-Attention ↓Cross-Attention ← Encoder 输出 ↓Decoder FFN ↓Linear ↓Softmax ↓下一个 TokenDecoder 每生成一个 Token就把它继续作为下一步输入再预测后面的 Token。比如输入I love AIDecoderSTART ↓我 ↓我 喜欢 ↓我 喜欢 AI ↓END这就是典型的自回归生成。这里还有一个容易忽略的区别训练阶段可以利用 Mask让一整段目标序列的多个位置并行参与计算。但推理生成阶段标准自回归 Decoder 仍然需要一个 Token 一个 Token 地往后生成。所以“Transformer 可以并行”不等于“生成文本时所有 Token 一次全部生成”。为什么今天的大模型离不开 TransformerTransformer 真正强大的地方不只是“有 Attention”。它把几件事组合到了一起• Token 之间可以直接建立关系• 序列训练具有较强的并行能力• 可以通过堆叠大量 Transformer Layer 扩展模型深度• Attention 和 FFN 都非常适合现代 GPU / AI 加速器上的矩阵计算• 架构可以灵活演化成 Encoder-only、Decoder-only、Encoder–Decoder 等不同形态这也是为什么从自然语言处理到视觉、多模态再到今天的大语言模型Transformer 都成为了极其重要的基础架构。不过它也不是没有代价。经典 Self-Attention 需要构造序列两两位置之间的注意力关系因此计算量和显存占用通常会随序列长度呈平方级增长。简单理解序列越长 ↓Attention 矩阵越大 ↓计算和显存压力越高这也是长上下文模型为什么需要持续优化 Attention、KV Cache、位置编码和推理实现的重要原因之一。最后理解 Transformer不需要一开始就死记复杂公式。先抓住一条主线Token ↓Embedding Position ↓Self-Attention和上下文交换信息 ↓FFN继续加工每个 Token 的表示 ↓层层堆叠 ↓形成更强的上下文表示如果是原始 Encoder–Decoder Transformer再在 Decoder 中加入Masked Self-Attention Cross-Attention完成条件生成。所以Transformer 的核心不是单独一个 Attention而是一套“Attention 负责信息交互、FFN 负责特征变换再通过残差、归一化和层堆叠不断深化表示”的完整架构。如果你现在再看到 Transformer 架构图能够顺着数据流解释清楚“Embedding → Attention → FFN → Encoder/Decoder → 输出”最关键的结构就已经理顺了。学AI大模型的正确顺序千万不要搞错了2026年AI风口已来各行各业的AI渗透肉眼可见超多公司要么转型做AI相关产品要么高薪挖AI技术人才机遇直接摆在眼前有往AI方向发展或者本身有后端编程基础的朋友直接冲AI大模型应用开发转岗超合适就算暂时不打算转岗了解大模型、RAG、Prompt、Agent这些热门概念能上手做简单项目也绝对是求职加分王给大家整理了超全最新的AI大模型应用开发学习清单和资料手把手帮你快速入门学习路线:✅大模型基础认知—大模型核心原理、发展历程、主流模型GPT、文心一言等特点解析✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑✅开发基础能力—Python进阶、API接口调用、大模型开发框架LangChain等实操✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经以上6大模块看似清晰好上手实则每个部分都有扎实的核心内容需要吃透我把大模型的学习全流程已经整理好了抓住AI时代风口轻松解锁职业新可能希望大家都能把握机遇实现薪资/职业跃迁这份完整版的大模型 AI 学习资料已经上传CSDN朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
Transformer 架构到底是怎么工作的?多头自注意机制又是什么?
你可能已经见过无数次这个词Transformer。这篇不从公式堆起而是先回答一个最重要的问题Transformer 到底是怎样把一串 Token变成对上下文的理解再一步步生成结果的Transformer 为什么会出现在 Transformer 之前处理文本序列常见的方案是 RNN、LSTM。它们有一个很直观的特点按顺序处理。例如一句话我 → 喜欢 → 学习 → 人工智能RNN 往往需要先处理“我”再处理“喜欢”然后才能继续处理后面的词。这种方式能够保留序列信息但也带来两个明显问题。一个是并行能力有限。前一步没有处理完后一步通常不能完全独立计算在 GPU 上很难把整段序列充分并行起来。另一个是长距离依赖难处理。一句话很长时前面的信息要经过很多步才能影响后面的词虽然 LSTM 等结构已经缓解了这个问题但依然存在较长的信息传递路径。2017 年Vaswani 等人在论文《Attention Is All You Need》中提出 Transformer不再依赖循环结构而是让序列中的 Token 通过 Attention 直接建立联系。这带来一个关键变化RNNToken1 → Token2 → Token3 → Token4TransformerToken1 ↔ Token2 ↔ Token3 ↔ Token4  Transformer 的核心思路不是“一个词接一个词地记”而是 让每个 Token 都有机会直接观察序列中的其他 Token再决定哪些信息与自己最相关。 这就是 Self-Attention 的价值。 Transformer 到底是什么 ------------------ 从完整结构看原始 Transformer 是一个典型的 Encoder–Decoder编码器–解码器架构。 可以先把它理解成两部分 plaintext 输入文本 ↓Encoder理解输入内容 ↓上下文表示 ↓Decoder根据上下文生成输出 ↓输出文本比如机器翻译I love machine learning ↓ Encoder ↓ 输入语义表示 ↓ Decoder ↓我喜欢机器学习Encoder 负责把输入“读懂”。Decoder 负责根据 Encoder 提供的信息以及自己已经生成的内容继续预测下一个 Token。在进入 Encoder 之前Token 先变成向量神经网络不能直接理解汉字或英文单词。文本通常先经过 Tokenizer被拆成 Token然后通过 Embedding 映射成向量。例如“我喜欢AI” ↓Tokenization ↓[我] [喜欢] [AI] ↓Embedding ↓向量1 向量2 向量3Embedding可以理解为把离散的 Token 转换成神经网络能够计算的一串数字。但这里只有“这个 Token 是什么”还缺一个重要信息它在句子里的什么位置因为 Self-Attention 本身不会像 RNN 一样天然按照先后顺序逐个处理 Token所以 Transformer 还需要加入位置信息。原始论文使用的是 Positional Encoding位置编码。于是进入 Transformer 层之前输入大致可以理解为Token Embedding Position Encoding ↓带有“内容 位置”信息的向量现代模型还会使用 RoPE 等其他位置编码方式但目的类似让模型知道 Token 之间的顺序和相对位置。Encoder 是怎么工作的一个经典 Transformer Encoder Layer可以先简化成两大模块输入 ↓Multi-Head Self-Attention ↓Add Norm ↓Feed Forward Network ↓Add Norm ↓输出这里最重要的是两件事Self-Attention 负责让不同 Token 交换上下文信息。Feed Forward Network 负责进一步处理每个 Token 得到的新表示。除此之外还有 Residual Connection残差连接和 Layer Normalization层归一化它们主要帮助深层网络稳定训练和传递信息。真正理解 Encoder关键还是 Self-Attention。Self-Attention 到底在算什么假设有一句话小明把苹果放在桌子上因为它很稳。看到“它”时人会结合上下文判断“它”更可能指向“桌子”。模型也需要完成类似的事情当前这个 Token应该重点关注上下文中的哪些 TokenSelf-Attention 就是在做这个计算。为了完成注意力计算每个 Token 会生成三组向量QQueryKKeyVValue可以先用非常粗略的方式理解• Q我现在想找什么信息• K我这里有什么特征可以被匹配• V如果你关注我我真正提供什么内容例如当前 Token 的 Q会和其他 Token 的 K 计算相似度。匹配程度越高说明当前 Token 越应该关注那个位置。整个过程可以简化为Q 和所有 K 做匹配 ↓得到注意力分数 ↓Softmax 转成权重 ↓按权重组合 V ↓得到新的上下文表示经典的 Scaled Dot-Product Attention 写成公式是Attention(Q, K, V) softmax(QKᵀ / √dₖ) V不用急着记公式。真正要记住的是Q 和 K 决定“关注谁”V 决定“拿什么信息回来”。这就是 Attention 最核心的逻辑。为什么还要 Multi-Head Attention如果只做一次 Attention模型可能只从一种关系理解句子。但语言里的关系很多。同一个 Token 可能同时需要关注• 谁是主语• 谁是宾语• 哪个词在修饰自己• 前后有哪些语义关联• 远距离位置上有没有关键信息所以 Transformer 不是只做一组 Attention而是同时使用多组不同的 Q、K、V 投影。这就是 Multi-Head Attention多头注意力。可以把它理解成同一段文本 ↓Head 1关注语法关系Head 2关注指代关系Head 3关注局部搭配Head 4关注长距离信息 ↓拼接 ↓得到更丰富的表示这里的“关注什么”并不是人工提前规定的而是在训练过程中学习出来的。因此多头注意力真正解决的是让模型能够从多个表示子空间同时观察 Token 之间的关系。Attention 后面为什么还有 FFNSelf-Attention 解决的是 Token 之间的信息交互。但信息交换完之后每个 Token 自己还需要继续“加工”。所以 Encoder 中还有 Feed Forward Network简称 FFN。经典形式可以简化成Token 表示 ↓Linear ↓激活函数 ↓Linear ↓新的 Token 表示它和 Attention 的职责不同Attention不同 Token 之间交换信息FFN对每个 Token 的表示继续做非线性变换这两类模块交替组合构成一个完整的 Transformer Layer。多个 Layer 再层层堆叠模型就能够逐步形成更复杂的表示。Add Norm 又是什么Transformer 架构图中经常还能看到Add Norm它主要包含两个东西。Residual Connection也叫残差连接。它不是只把某个子模块的输出继续往下传而是把输入也加回来输出 输入 子模块(输入)这样可以让原始信息更容易跨层传递也有助于深层网络训练。Layer NormalizationLayerNorm 会对特征做归一化处理帮助训练过程更加稳定。所以看到Attention ↓Add Norm不要把它理解成另一个复杂的“智能模块”。它更像是为了让整个深层网络稳定运行的重要结构设计。需要注意的是原始 Transformer 论文与很多现代大模型在 LayerNorm 的具体放置顺序上并不完全相同。理解整体架构时先知道它承担“稳定训练和信息传递”的作用就够了。一个完整的 Transformer 流程把前面的模块全部串起来原始 Transformer 可以简化成下面这条链路输入文本 ↓Tokenizer ↓Embedding Position ↓Encoder Self-Attention ↓Encoder FFN ↓上下文表示 ↓────────────────────── ↓Decoder 输入 ↓Embedding Position ↓Masked Self-Attention ↓Cross-Attention ← Encoder 输出 ↓Decoder FFN ↓Linear ↓Softmax ↓下一个 TokenDecoder 每生成一个 Token就把它继续作为下一步输入再预测后面的 Token。比如输入I love AIDecoderSTART ↓我 ↓我 喜欢 ↓我 喜欢 AI ↓END这就是典型的自回归生成。这里还有一个容易忽略的区别训练阶段可以利用 Mask让一整段目标序列的多个位置并行参与计算。但推理生成阶段标准自回归 Decoder 仍然需要一个 Token 一个 Token 地往后生成。所以“Transformer 可以并行”不等于“生成文本时所有 Token 一次全部生成”。为什么今天的大模型离不开 TransformerTransformer 真正强大的地方不只是“有 Attention”。它把几件事组合到了一起• Token 之间可以直接建立关系• 序列训练具有较强的并行能力• 可以通过堆叠大量 Transformer Layer 扩展模型深度• Attention 和 FFN 都非常适合现代 GPU / AI 加速器上的矩阵计算• 架构可以灵活演化成 Encoder-only、Decoder-only、Encoder–Decoder 等不同形态这也是为什么从自然语言处理到视觉、多模态再到今天的大语言模型Transformer 都成为了极其重要的基础架构。不过它也不是没有代价。经典 Self-Attention 需要构造序列两两位置之间的注意力关系因此计算量和显存占用通常会随序列长度呈平方级增长。简单理解序列越长 ↓Attention 矩阵越大 ↓计算和显存压力越高这也是长上下文模型为什么需要持续优化 Attention、KV Cache、位置编码和推理实现的重要原因之一。最后理解 Transformer不需要一开始就死记复杂公式。先抓住一条主线Token ↓Embedding Position ↓Self-Attention和上下文交换信息 ↓FFN继续加工每个 Token 的表示 ↓层层堆叠 ↓形成更强的上下文表示如果是原始 Encoder–Decoder Transformer再在 Decoder 中加入Masked Self-Attention Cross-Attention完成条件生成。所以Transformer 的核心不是单独一个 Attention而是一套“Attention 负责信息交互、FFN 负责特征变换再通过残差、归一化和层堆叠不断深化表示”的完整架构。如果你现在再看到 Transformer 架构图能够顺着数据流解释清楚“Embedding → Attention → FFN → Encoder/Decoder → 输出”最关键的结构就已经理顺了。学AI大模型的正确顺序千万不要搞错了2026年AI风口已来各行各业的AI渗透肉眼可见超多公司要么转型做AI相关产品要么高薪挖AI技术人才机遇直接摆在眼前有往AI方向发展或者本身有后端编程基础的朋友直接冲AI大模型应用开发转岗超合适就算暂时不打算转岗了解大模型、RAG、Prompt、Agent这些热门概念能上手做简单项目也绝对是求职加分王给大家整理了超全最新的AI大模型应用开发学习清单和资料手把手帮你快速入门学习路线:✅大模型基础认知—大模型核心原理、发展历程、主流模型GPT、文心一言等特点解析✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑✅开发基础能力—Python进阶、API接口调用、大模型开发框架LangChain等实操✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经以上6大模块看似清晰好上手实则每个部分都有扎实的核心内容需要吃透我把大模型的学习全流程已经整理好了抓住AI时代风口轻松解锁职业新可能希望大家都能把握机遇实现薪资/职业跃迁这份完整版的大模型 AI 学习资料已经上传CSDN朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】